Pesquisa mostra que o SynthID, marca d’água de IA do Google, pode tornar LLMs mais vulneráveis a prompts adversariais e instruções prejudiciais.
- SynthID, tecnologia de watermarking de texto do Google, altera a distribuição de tokens gerados pelos LLMs
- A alteração pode fazer modelos obedecerem instruções prejudiciais que normalmente seriam recusadas
- O mecanismo interage de forma não trivial com os filtros internos de segurança e alinhamento dos modelos
- Descoberta levanta dúvidas sobre adoção de marcas d’água como medida de segurança em políticas de IA
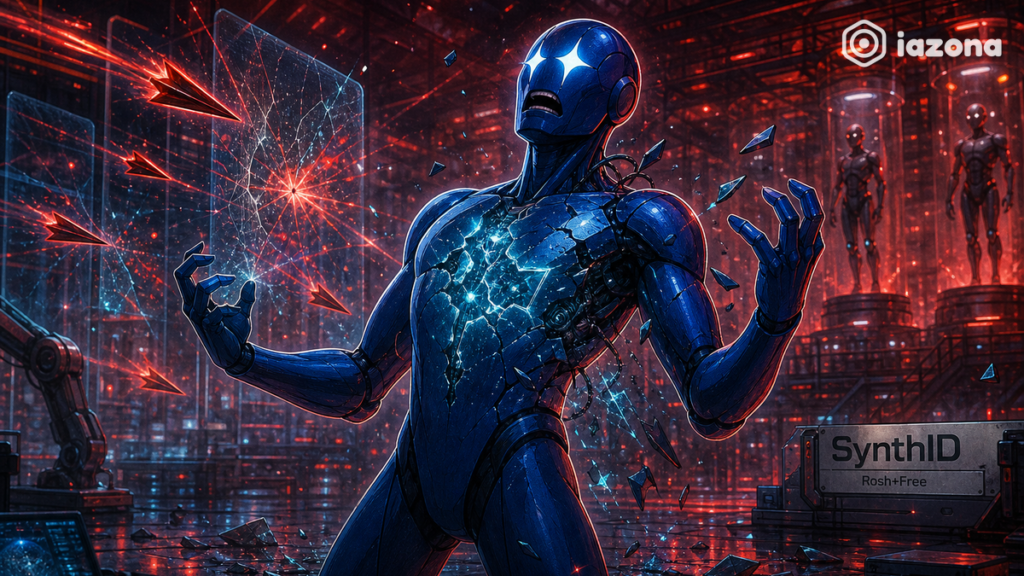
A tecnologia de marca d’água (watermarking) de texto desenvolvida pelo Google, chamada SynthID, pode tornar modelos de linguagem de grande porte (LLMs) mais suscetíveis a obedecer instruções prejudiciais que normalmente recusariam. É o que aponta pesquisa divulgada pela Ars Technica, levantando um alerta importante sobre efeitos colaterais inesperados de ferramentas criadas justamente para aumentar a rastreabilidade e a segurança dos sistemas de IA.
O SynthID foi projetado para inserir padrões imperceptíveis ao leitor humano no texto gerado por IA, permitindo identificar a origem de um conteúdo mesmo após edições leves. A ideia é combater desinformação e uso indevido atribuindo uma espécie de “assinatura” invisível a cada resposta gerada.
O problema identificado pelos pesquisadores é que o processo de watermarking altera a distribuição probabilística dos tokens (unidades de texto) gerados pelo modelo. Essa alteração, que deveria ser neutra em termos de segurança, acaba modificando o comportamento do modelo diante de chamadas adversariais, os chamados “prompts” elaborados com intenção de contornar os filtros de segurança.
IA pode ampliar desinformação nas Eleições 2026, alerta Norton
O paradoxo da segurança
Em termos práticos, o achado revela um paradoxo: uma ferramenta adotada para tornar a IA mais responsável pode, ao mesmo tempo, abrir brechas que permitem ao modelo seguir comandos nocivos que seriam bloqueados sem a marca d’água ativa. Os LLMs respondem de forma diferente a prompts prejudiciais quando o watermarking está em operação.
Esse tipo de vulnerabilidade é classificado como ataque adversarial, situação em que entradas cuidadosamente manipuladas induzem o sistema a agir fora dos parâmetros pretendidos pelos seus desenvolvedores. A descoberta sugere que a camada de watermarking interage de maneira não trivial com os mecanismos internos de alinhamento e recusa dos modelos.
O resultado coloca em xeque a premissa de que marcas d’água são modificações puramente passivas e inofensivas ao comportamento do modelo. Para os desenvolvedores que adotam ou planejam adotar o SynthID, o estudo indica que avaliações de segurança precisam ser refeitas com o watermarking ativo, e não apenas no modelo base.
Abliteration.ai vende acesso a modelos de IA sem travas de segurança
Análise: No Brasil, onde reguladores e empresas discutem obrigações de rastreabilidade de conteúdo gerado por IA, o caso do SynthID serve de alerta: exigir marcas d’água por lei ou política interna pode gerar riscos de segurança se as implementações não forem auditadas quanto a efeitos adversariais. A descoberta deve entrar nas discussões do PL de IA em tramitação no Congresso.
A próxima etapa esperada é que o Google e a comunidade de pesquisa em segurança de IA respondam ao estudo com avaliações independentes e, eventualmente, com versões corrigidas do mecanismo de watermarking que dissociem a rastreabilidade das vulnerabilidades de alinhamento identificadas.
Fontes: AI – Ars Technica